语义搜索、检索增强生成、图片去重、推荐召回,背后都有一个相同的动作:把查询变成一条向量,然后在一大堆向量里找出最接近的 k 条。数据量小的时候,全部比一遍就好;数据量上来之后,”全部比一遍”会成为整个系统的瓶颈。
HNSW(Hierarchical Navigable Small World)是过去几年部署最广的近似最近邻索引之一。它的目标不是把距离算得更快,而是少算很多次:用一张分层的图,把线性扫描变成一次从粗到细的游走。
这篇文章按”问题—原理—例子—参数—边界”的顺序,把 HNSW 拆开讲清楚。
一、先把成本算清楚
假设有 N 条向量,每条 d 维,用 float32 存储。原始向量占 4Nd 字节;一次精确的 k 近邻查询要和每条向量算一次距离,也就是 N 次 d 维距离计算。
以一个不算夸张的规模为例:100 万条 768 维向量,这是很多文本嵌入模型的常见输出维度。
- 原始向量:1,000,000 × 768 × 4 B = 3.072 GB。
- 单次查询的乘加次数:1,000,000 × 768 = 7.68 亿次;按一次乘加 2 FLOP 计,约 1.54 GFLOP。
- 如果 CPU 对这组数据能达到 20–100 GFLOP/s 的有效吞吐,纯计算约 15–77 ms。
- 但暴力扫描还要把这些向量从内存搬到 CPU。3.072 GB 按 20–50 GB/s 的有效带宽算,仅数据搬运就要 61–154 ms。
| 有效内存带宽 | 仅搬完 3.072 GB 向量的时间 |
|---|---|
| 20 GB/s | 约 154 ms |
| 50 GB/s | 约 61 ms |
| 100 GB/s | 约 31 ms |
所以精确检索的瓶颈往往不是浮点运算,而是内存带宽:每次查询都要把整份向量数据流一遍。数据量再大一个数量级,单机就顶不住了。这里的数字是按公式做的数量级估算,不是某台机器的实测;真实值取决于 CPU、内存、NUMA、SIMD、缓存命中和具体实现。
近似最近邻(ANN)换了一个思路:不保证返回的 k 个邻居是全局精确的,而是以很高的概率返回足够好的结果。很多团队会把召回率目标定在 95% 以上,同时把每次查询参与比较的向量数从 N 降到几百到几千。HNSW 就是这类索引里最常见的一种。
二、图为什么能减少比较
最直接的剪枝思路是建一张”邻近关系图”:每个向量是图上的一个节点,只和它附近的一些向量连边。查询时从一个入口节点出发,计算查询点到当前节点邻居的距离,往更近的邻居走,直到周围没有更近的节点为止。
这就是贪心游走。它每次只比较当前节点的少量邻居,而不是全量数据。如果图建得好,几步就能接近目标。
但只连”最近的一些邻居”会有一个问题:图可能被切成很多局部区域,长距离的边很少。查询点如果落在另一个区域,贪心游走会走进局部最优——周围没有更近的邻居,但离真正的目标还很远。反过来,如果为了跨区域而大量连长边,近邻的精度又会被稀释。
早期的 NSW(Navigable Small World)图试图用”小世界”性质解决这个矛盾:少量长边负责跨越,大量短边负责精修。但单层图很难同时把两种尺度照顾好,规模上来之后,搜索步数会变多。
HNSW 的关键改动是:把不同尺度的边拆到不同的层。
三、HNSW 的分层结构
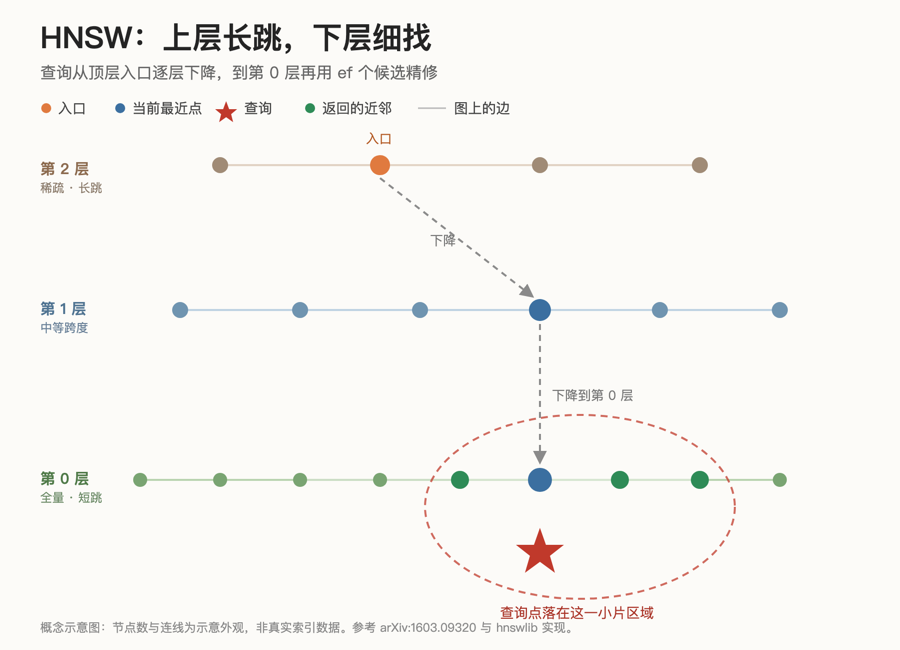
HNSW 维护一组嵌套的图。第 0 层包含全部向量,边最短、最密;往上每一层只保留一部分节点,边更长、更稀;最顶层是一个很小的”高速公路”,负责把搜索快速带到目标附近。
每个节点被分到哪一层,不是按语义聚类算出来的,而是在插入时随机采样得到的。原论文的描述是:节点的最高层按指数衰减的概率分布选取。hnswlib 的实现更具体:
level = floor(-log(U) * (1 / log(M))) # U 是 (0,1) 上的均匀随机数
这个式子等价于:节点出现在第 l 层及以上的概率是 (1/M)^l。在这个采样式里,M 越大,高层节点越少;同时每层的连接数上限越大。以 M=16、100 万条向量为例,各层的期望节点数是:
| 层 | 期望节点数 | 作用 |
|---|---|---|
| 第 0 层 | 1,000,000 | 全部向量,短边精修 |
| 第 1 层 | 62,500 | 中等跨度 |
| 第 2 层 | 3,906 | 较大跨度 |
| 第 3 层 | 244 | 跨区域 |
| 第 4 层 | 15 | 顶层附近的稀疏图 |
| 第 5 层 | 约 1 | 最顶层入口 |
期望层数大约是 log_M(N)。M=16 时,log_16(1000000) ≈ 5,和上面的表一致。这个结构和跳表(skip list)很像:顶层稀疏、底层稠密,查询时先大步跳,再逐层缩小范围。原论文也指出,正是这种”尺度分离”让 HNSW 能够达到对数级的复杂度增长。
在连接数上,hnswlib 的实现给第 0 层留了 2M 条边的上限,其余层是 M 条。第 0 层最密,因为它要负责最终的精细比较;上层节点少,M 条边已经足够做跨区域导航。
四、搜索与插入:图是怎么用的
4.1 查询:从顶层逐层下降
一次 HNSW 查询分两段:
- 从最顶层的入口点开始,在每一层做
ef=1的贪心搜索:只保留当前最近的一个点,沿着更近的邻居走,直到这一层没有更近的邻居。 - 带着当前最近点下降到下一层,重复上面的过程;到第 0 层时,把候选列表扩大到
ef(通常大于 k),做一次有界的最佳优先搜索,最后返回最近的 k 个。
上层的作用是”快速接近”,第 0 层的作用是”在附近仔细找”。因为上层节点数按 M 的幂次衰减,每下降一层,节点规模就缩小大约 M 倍;总层数是对数级的,所以整个路径也是对数量级的。
第 0 层的核心是一个带候选列表的搜索过程。用伪代码表示:
search_layer(q, entry_points, ef, layer):
    visited = {entry_points}
    candidates = 最小堆(按 dist(q, x) 排序)
    results = 最大堆(按 dist(q, x) 排序,最多 ef 个)
    while candidates 非空:
        c = 取出 candidates 中离 q 最近的点
        if len(results) == ef and dist(q, c) > results 中最远的距离:
            break
        for e in neighbors(c, layer):
            if e in visited: continue
            visited.add(e)
            if len(results) < ef or dist(q, e) < results 中最远的距离:
                push(candidates, e)
                push(results, e)
                if len(results) > ef:
                    pop(results 中最远的点)
    return results
ef 就是候选列表的容量,它直接决定了查询时愿意看多少个点。ef 越大,越不容易漏掉真正的近邻,但距离计算也越多。
4.2 插入:每层找邻居,再双向连边
插入一个新节点 q 时,HNSW 做的是:
- 采样 q 的最高层 l。
- 从顶层开始,用
ef=1的贪心搜索逐层下降,直到第 l+1 层,找到一个合适的入口。 - 从第 l 层往下,在每一层用
ef_construction大小的候选列表搜索,选出最多 M 个邻居,建立双向边;如果某个节点的边数超过上限,就用同一套启发式规则裁掉较差的边。
这里的邻居选择不是简单地取”最近的 M 个”。原论文使用了一个启发式:候选邻居不仅要离新节点近,还要和已经选中的邻居保持足够距离,避免所有边都挤在同一个局部方向。这个细节在高度聚类的数据上很重要,也是 HNSW 在高召回区间表现好的原因之一。
插入的代价比查询高:每个新节点要在多个层里做搜索,还要维护邻居关系。所以 HNSW 的构建通常比 IVFFlat 这类”先聚类、再倒排”的索引慢,内存也更大。
五、参数怎么选:M、ef_construction、ef_search
HNSW 的可调参数不多,但每一个都直接影响召回率、延迟和内存。以 hnswlib 和 pgvector 的文档为参考:
| 参数 | 作用、调大后的影响与常见取值 |
|---|---|
M |
每个节点在每层的最大连接数。调大后图更密、召回更高,内存和构建时间增加。hnswlib 建议多数场景 12–48,高维嵌入可到 48–64。 |
ef_construction |
构建时每层的候选列表大小。调大后图质量更好,构建更慢。hnswlib 示例用 200,pgvector 默认 64。 |
ef_search / ef |
查询时第 0 层的候选列表大小。调大后召回更高、查询更慢。pgvector 默认 40,且必须不小于 k。 |
几个容易忽略的点:
ef不能小于 k。 hnswlib 的文档明确要求它不低于要返回的邻居数;实际使用时通常会设成 k 的几倍,留出余量。M和ef_construction不是独立的。 hnswlib 的文档给了一个经验:在相近的构建质量下,M × ef_construction可以粗略看成常数。把 M 翻倍,ef_construction 通常可以减半。ef不一定保存在索引里。 hnswlib 的ef是查询时设置的,加载索引后要手动设;pgvector 则通过hnsw.ef_search会话参数控制。- 默认值只是起点。 pgvector 的默认值是
m=16、ef_construction=64、ef_search=40,适合先跑通,不代表在你的数据上召回率就够。
判断参数是否合适,唯一可靠的办法是在自己的数据上测召回率:抽样一批查询,用精确暴力搜索算出真实的 top-k,再和 HNSW 的结果比对。hnswlib 的文档还给了构建阶段的一个自检方法:如果令 ef = ef_construction 时,M 近邻的召回率低于 0.9,说明图的质量还有提升空间。
下面这段 Python 代码把前面的层节点数和图内存算一遍,方便你按自己的 N、d、M 替换:
import math

N, d, M = 1_000_000, 768, 16

raw = N * d * 4
print(f"raw vectors: {raw / 1e9:.3f} GB")

for level in range(6):
    print(f"layer {level}: {N * (1 / M) ** level:,.0f} nodes")

layer0 = N * (2 * M * 4 + 4)
upper = sum(N * (1 / M) ** level for level in range(1, 6)) * (M * 4 + 4)
print(f"graph: {(layer0 + upper) / 1e6:.1f} MB")
print(f"graph / raw: {(layer0 + upper) / raw * 100:.2f}%")
在 100 万条 768 维 float32 向量的例子里,输出是:原始向量 3.072 GB;第 0 层 1,000,000 个节点,往上依次约 62,500、3,906、244、15、1 个;只算邻接表的图结构约 136.5 MB,约为原始向量的 4.4%。
这个结果和 hnswlib 文档给的经验值能对上:图结构的内存大约是每个元素 M × 8–10 字节(不含向量本身)。M=16 时是 128–160 字节/元素,和上面按 32 条边、每条 4 字节算出的 132 字节在同一量级。注意这只是邻接表;真实索引还要存向量、ID、对齐填充和元数据。不同实现把这些东西放在哪里不一样,算容量时要以实际索引大小为准,不要只用这张表估算。
六、真实系统里的坑
6.1 过滤条件会把结果”吃掉”
很多业务查询不是纯粹的向量检索,而是”先按租户、分类、时间过滤,再找最近邻”。HNSW 的图是按向量距离建的,不知道你的过滤条件;多数实现会先扫索引,再对候选应用过滤。
pgvector 的文档给了一个很直观的例子:如果一个过滤条件只匹配 10% 的行,而 hnsw.ef_search 用默认的 40,那么平均只有 4 行能通过过滤。你以为会返回 10 条,实际可能只有 3–4 条。这不是 bug,是”先近邻、后过滤”的必然结果。
应对方式有三种:
- 开启迭代索引扫描(pgvector 0.8.0+ 的
hnsw.iterative_scan),让索引在结果不够时继续往下扫;strict_order保证严格按距离排序,relaxed_order召回更好但顺序可能略有出入。 - 如果过滤字段只有少数几个取值,建部分索引(partial index),例如只对某个分类建 HNSW。
- 如果过滤字段很多、选择率又低,考虑按字段分区,或者先过滤出较小的候选集,再在小集合上做精确搜索。
6.2 删除和更新会留下”死条目”
HNSW 的图是增量维护的。删除一个向量时,多数实现不会立刻把节点从图里摘掉,而是标记为删除;更新则往往等价于”插入新向量 + 标记旧向量”。这些死条目仍然占着图里的位置,查询时可能被扫到,导致返回结果变少或变慢。
hnswlib 提供了 allow_replace_deleted,允许新元素复用已删除元素的位置;pgvector 的文档则明确提示,dead tuples 会让查询结果变少,并建议在 vacuum 前先 REINDEX INDEX CONCURRENTLY,否则 HNSW 索引的 vacuum 可能很慢。写入频繁、删除率高的场景,要把重建周期和索引膨胀算进容量规划。
6.3 维度和构建内存
pgvector 的 HNSW 对 vector 类型支持到 2,000 维,halfvec 支持到 4,000 维。维度越高,原始向量越大,距离计算也越贵。如果模型输出维度很高,可以先做降维,或者用半精度、乘积量化等方式压缩,但要重新测召回率——压缩会改变距离的排序。
构建阶段,pgvector 会尽量把图放进 maintenance_work_mem;放不下时会提示构建会显著变慢。100 万条向量的图不是小对象,构建前要把内存和并行度一起规划,别让索引构建把数据库的内存打满。
6.4 它不是唯一的选择
HNSW 不是所有场景的最优解:
- 数据量小:几万条向量,暴力扫描可能只要几毫秒,维护一张图反而增加复杂度和内存。
- 要求 100% 精确:HNSW 是近似算法,不能保证召回全部真实近邻;合规、计费等场景要用精确搜索。
- 构建资源紧、写入极频繁:IVFFlat 构建更快、内存更省,但需要训练数据,速度-召回通常不如 HNSW。
- 数据量极大、内存放不下:可以考虑磁盘驻留的索引(如 DiskANN 类方案),或者用量化把向量压到内存里。
pgvector 的文档对 HNSW 和 IVFFlat 的对比说得很直接:HNSW 在速度-召回权衡上更好,但构建更慢、内存更多,而且不需要训练步骤。选哪个,取决于你更怕延迟、内存还是构建时间。
七、一张检查清单
如果你准备在自己的项目里上 HNSW,可以先回答这七个问题:
- N 和 d 是多少? 原始向量占多少内存?索引加上图之后,单机放得下吗?
- 能接受多少召回损失? 用抽样查询和精确结果比对过 recall@k 吗?
- M、ef_construction、ef_search 是怎么定的? 是照抄默认值,还是在自己的数据上测过?
- 查询带过滤条件吗? 过滤选择率多少?需不需要迭代扫描、部分索引或分区?
- 写入和删除的频率如何? 死条目和索引膨胀由谁清理?重建窗口在哪?
- 索引和查询用的是同一个距离度量吗? 向量有没有归一化?余弦和内积不能混着用。
- 真的需要 ANN 吗? 数据量小、要求精确、或者过滤条件占主导时,精确搜索可能更简单。
HNSW 的快,不是因为距离算得更快,而是因为它只算该算的那一小部分:上层用长边快速接近,下层用短边仔细比较,层数随数据量对数增长。它用”可能漏掉”换来了数量级的延迟下降;参数、过滤、删除和内存,则决定了这笔交易在你的场景里是否划算。
参考资料
- Malkov, Y. A., & Yashunin, D. A. Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. arXiv:1603.09320v4, 2018. https://arxiv.org/abs/1603.09320
- hnswlib:header-only C++ HNSW 实现与 Python 绑定. https://github.com/nmslib/hnswlib
- hnswlib 参数说明(M、ef、ef_construction 的取值范围与经验值). https://github.com/nmslib/hnswlib/blob/master/ALGO_PARAMS.md
- hnswlib 源码中第 0 层
2M连接上限与层采样实现. https://github.com/nmslib/hnswlib/blob/master/hnswlib/hnswalg.h - pgvector:Postgres 向量类型与 HNSW/IVFFlat 索引文档. https://github.com/pgvector/pgvector
说明:文中的层节点数、内存和图结构比例是按论文与 hnswlib 实现中的公式做的算术推演,用于说明数量级;延迟数字是按有效算力和内存带宽做的估算,不是基准测试结果。真实表现取决于硬件、数据分布、实现细节和参数配置。