如果你只用过 git log -p 和 git diff,很容易把 Git 想成一个“记录每次改了哪几行”的系统。这个直觉在界面层没错,在存储层恰好相反:提交对象里没有一行 diff。git show 看到的补丁,是 Git 读取时拿两个 tree 现算的;真正落盘的是每个提交指向的完整目录树,以及被改动文件的完整新内容。
那 Git 为什么没有随着提交数量线性膨胀?因为“逻辑上存快照”和“物理上省空间”是两件事。Git 用对象模型保存快照,再用 packfile、delta 和传输协商把重复内容压下去。把这两层分开看,很多关于 Git 的困惑——为什么提交不保存 diff、为什么二进制文件也能增量、为什么 git gc 有时很慢——就会变得顺理成章。
先给结论:
- 提交指向一棵完整的根 tree;tree 再指向 blob 和子树。没有变化的文件继续复用同一个 blob 对象,所以“快照”不等于“每个提交复制整个仓库”。
- 单个对象先是 loose object,一个对象一个 zlib 压缩文件;
git gc会把它们收进 packfile,并在 pack 内用 delta 表示相似对象。 - clone/fetch 传的是 pack,而且可以是省略公共基对象的 thin pack;客户端补全后才能落盘。线上字节、落盘体积、完整历史是三个不同层面的数字。
下面用一个可复现的合成仓库,把这套机制从对象、pack 到传输走一遍。所有数字都来自本机实测,不是估算。文中代码块在窄屏下可以横向滑动,不影响复制。
一、git show 的 diff 是算出来的
先从最小的对象开始。Git 的 blob 只保存文件内容,对象 ID 是内容加上类型和长度头的 SHA-1。官方文档里的例子:
$ printf 'what is up, doc?' | git hash-object --stdin
bd9dbf5aae1a3862dd1526723246b20206e5fc37
这 16 个字节并不是直接做哈希。Git 先在前面加上 blob 16\0,再对“头 + 内容”计算 SHA-1。头里的类型和长度同样参与哈希,所以同一段内容如果被当成不同类型或不同长度,对象 ID 就会不同。git cat-file -p 展示的是去掉头之后的载荷,头本身由 git cat-file -t 和 git cat-file -s 分别回答类型与大小。
提交对象也不保存 diff。它的原始内容大致是:
tree <根 tree 的对象 ID>
parent <父提交的对象 ID>
author <作者与时间>
committer <提交者与时间>

<提交说明>
根提交没有 parent,合并提交有多个 parent。仅此而已。git show 之所以能打印补丁,是因为它先找到提交指向的 tree,再和父提交的 tree 做树间比较;git log -p 则沿着 parent 链逐个算。diff 是读取时的派生结果,不是提交的存储格式。
这和“快照”是什么关系?看一个合成仓库:31 个提交,每次都改 notes.txt,中途把 96 KiB 的随机二进制文件改了一次,README.md 始终不动。跑完以后对象总数是 96 个:
- 31 个 commit;
- 31 个 tree;
- 34 个 blob。
34 个 blob 的构成正好说明了快照的复用方式:31 个版本的 notes.txt 各有一个完整 blob,二进制文件有 2 个版本,README.md 只有 1 个。31 棵 tree 都引用同一个 README.md blob;改一次 notes.txt,只会新增一个 blob 和一棵新的根 tree,未变的二进制文件和 README 不需要重新写入。
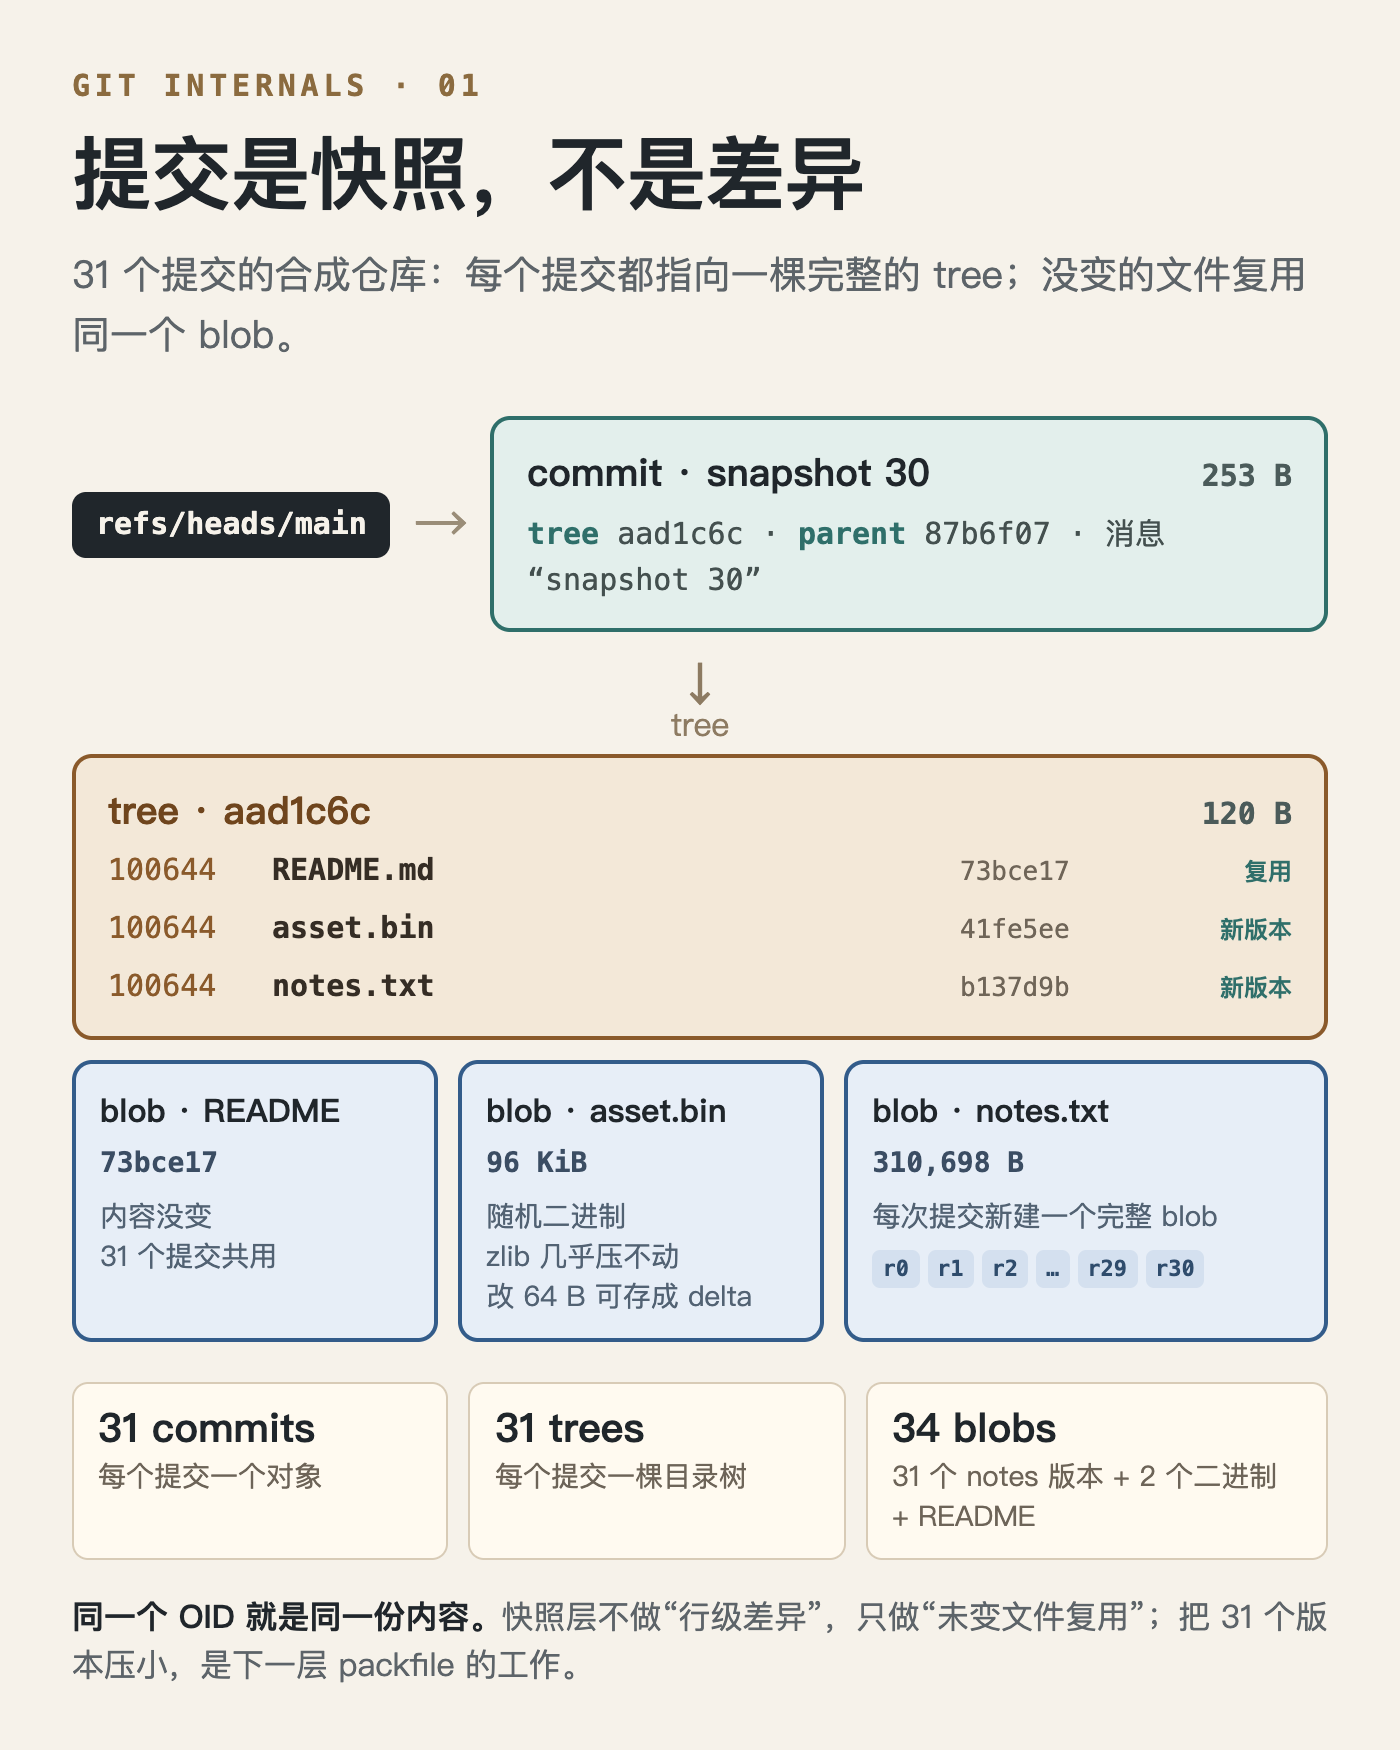
图 1:提交指向 tree,tree 指向 blob。改一个文件只产生新 blob 和新 tree;未变的 blob 继续被复用。
所以“Git 存快照”的准确含义是:每个提交都能独立还原出完整目录结构,但对象库通过内容寻址自动去重。快照是逻辑承诺,复用是物理实现。两者并不矛盾。
二、loose object:一个对象一个文件
新写入的对象先以 loose object 形式存在。blob 的磁盘路径由对象 ID 决定:前两个十六进制字符做目录,剩下 38 个字符做文件名,例如 .git/objects/b1/37d9...。文件内容是 zlib 压缩后的“头 + 载荷”。
实测一个 310,698 字节的文本 blob:加上 blob 310698 头和 NUL 分隔符后,未压缩对象是 310,710 字节;落到磁盘是 25,280 字节,压缩比约 12.29 倍。对象 ID 重新计算后与 git rev-parse 给出的值一致。小对象就没这么好看了:一个 111 字节载荷的 tree,加上 tree 111 头之后是 120 字节,磁盘上 121 字节;一个未压缩对象 253 字节的 commit,磁盘上 167 字节。zlib 对短内容本来就没有多少压缩空间,文件头和文件系统块的开销反而更显眼。
tree 的原始格式也值得看一眼。它不是 JSON,也不是文本 diff,而是一串紧凑的二进制条目:
100644 README.md\0<20 字节 SHA-1>
100644 asset.bin\0<20 字节 SHA-1>
100644 notes.txt\0<20 字节 SHA-1>
每项包含模式、文件名、NUL 分隔符和 20 字节的二进制对象 ID。100644 是普通文件,100755 是可执行文件,120000 是符号链接,040000 是子树。这个 tree 的载荷是 111 字节,加上 tree 111 头(9 字节)是 120 字节;zlib 后落盘 121 字节,几乎没有压缩。tree 只记录“目录里有什么、指向哪个对象”,不重复保存文件内容。
commit 里的 tree 字段指向根 tree;根 tree 再指向子 tree 和 blob。这个对象图是有向无环图:提交通过 parent 往回指,tree 通过对象 ID 往下指,分支和标签则是指向某个提交的引用。git log 走的是父链,git diff A B 比较的是两棵 tree,git checkout 则根据 tree 里的对象 ID 把内容取出来。
这时的 git count-objects -v 会给出 96 个 loose 对象、size: 1300(单位 KiB,四舍五入)。注意这个 1300 是所有 loose 文件磁盘占用之和,不是未压缩载荷之和;拿它和后面的 pack 字节数比较时,要知道口径差异。
loose 形式的问题也很直接:对象一多,文件系统里就是大量小文件;每个版本单独压缩,跨版本重复内容没有被利用;备份、同步和目录遍历都更费事。git gc 的核心工作之一,就是把这些对象收进更紧凑的 pack。
三、packfile:对象流、delta 与索引
对合成仓库执行一次常规 git gc 后,96 个 loose 对象变成 1 个 pack 和 1 个 idx:
- pack 文件 151,310 字节;
- idx 文件 3,760 字节;
git verify-pack -v统计到 96 个对象,其中 47 个完整对象、49 个 delta。
拿 1,300 KiB(约 1,331,200 字节)和 151,310 + 3,760 = 155,070 字节相比,大约小了 8.6 倍。这个比例只属于这个合成仓库,不能当成通用压缩率;但它足以说明 pack 不是简单把 loose 文件打成一个 tar 包。
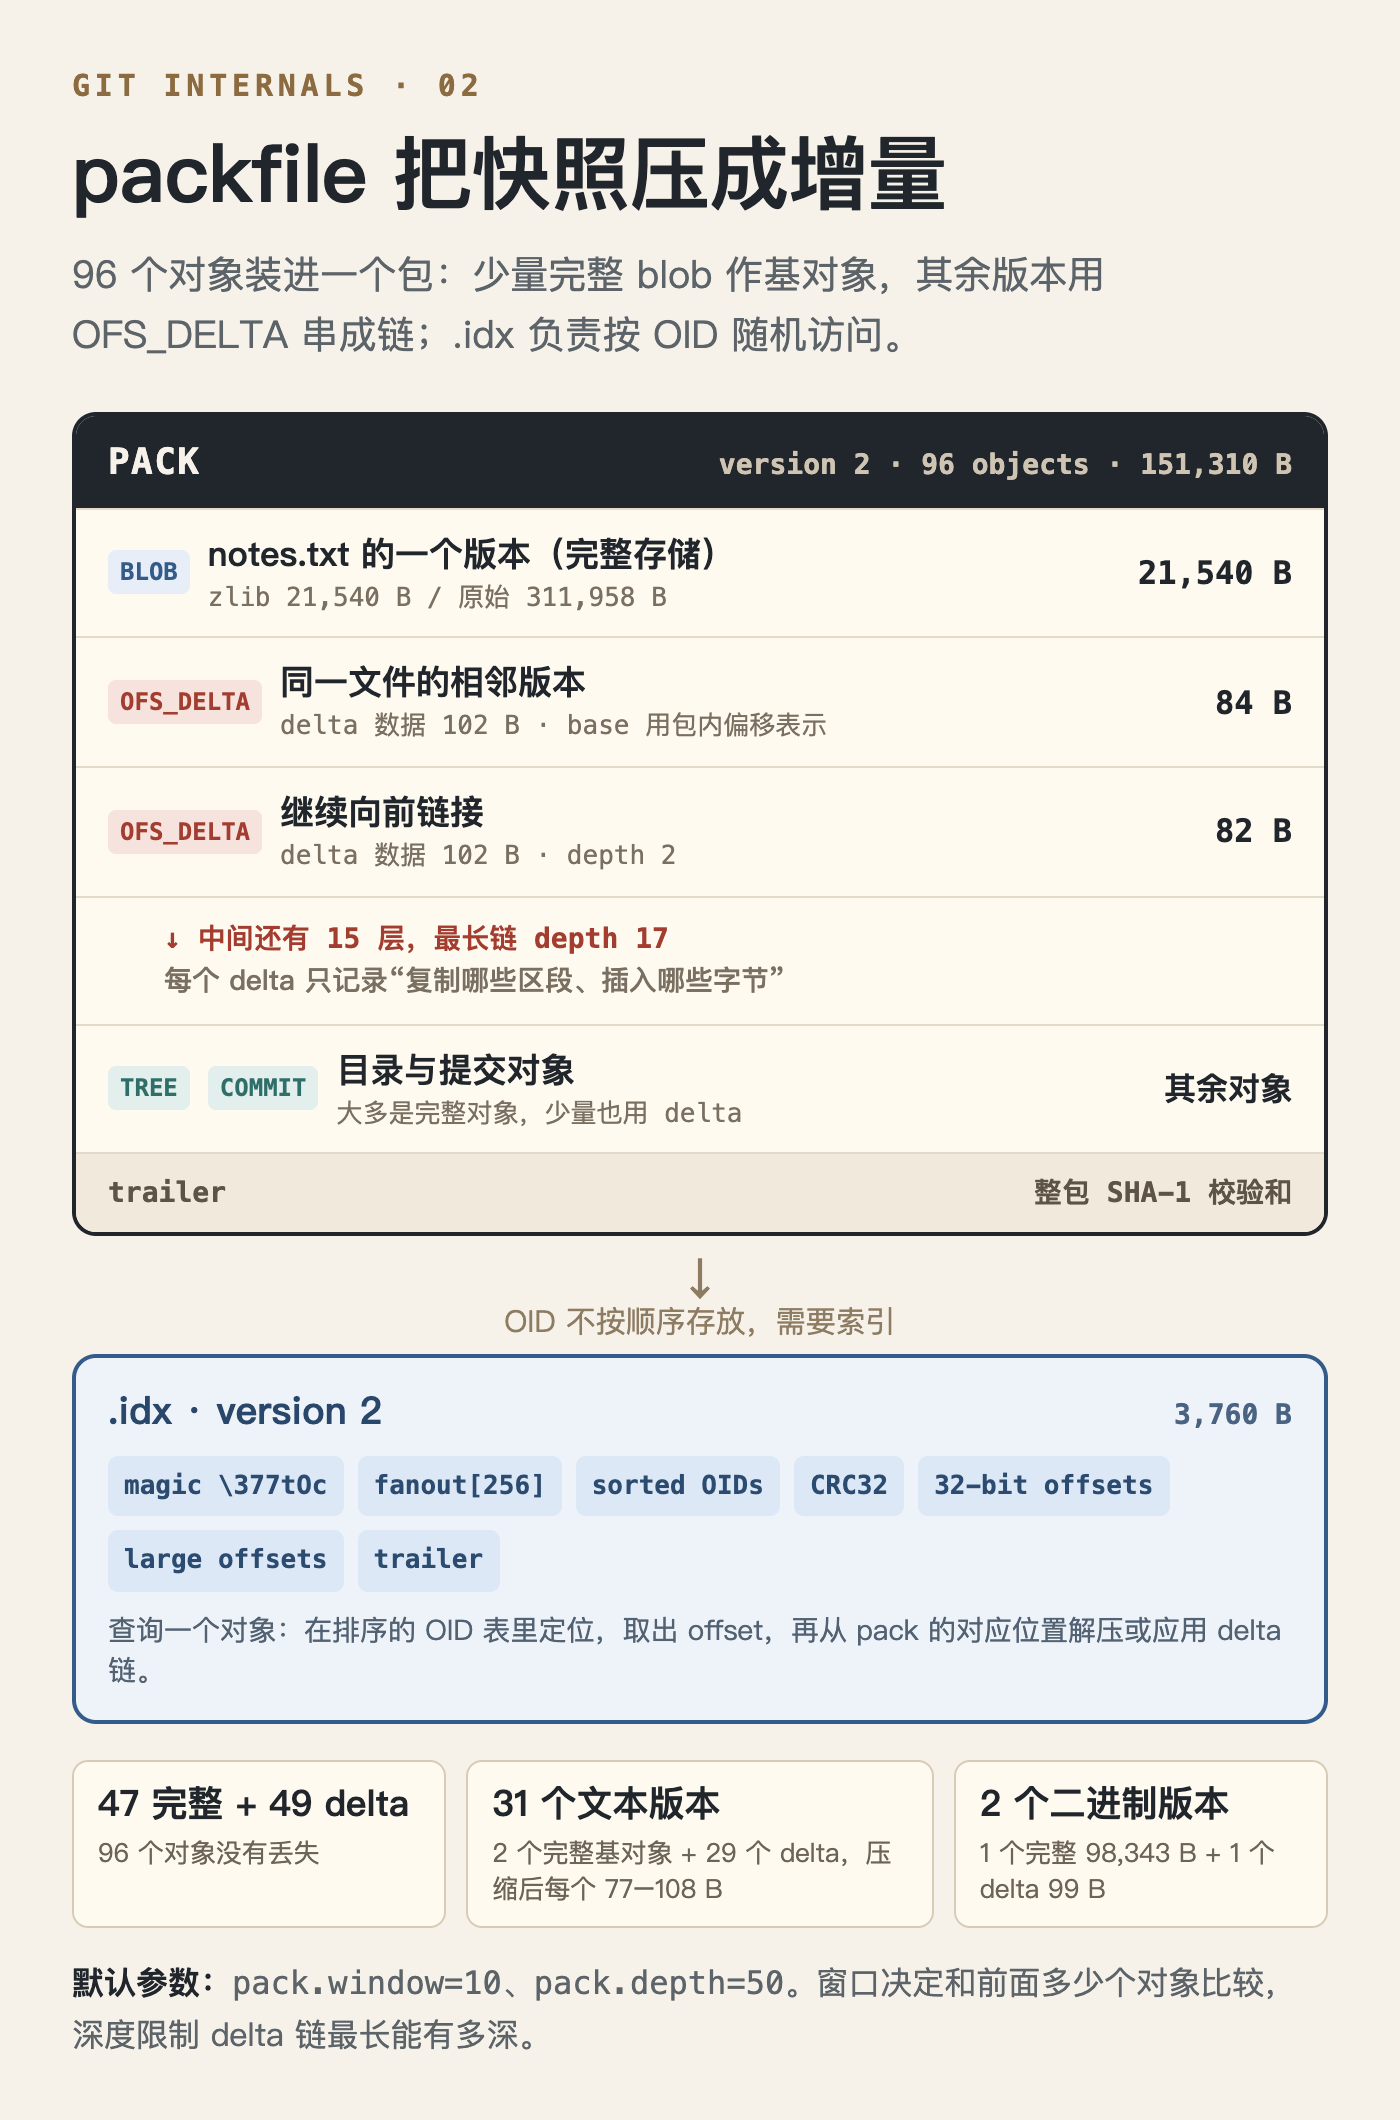
图 2:packfile 是对象流,idx 把对象 ID 映射到偏移;delta 对象可以指向包内偏移,也可以指向另一个对象的 ID。
pack 文件的结构可以粗略分成三段:
- 头部:
PACK魔数、版本号、对象数量。版本 2 是现在最常见的格式。 - 对象条目:每个条目先写类型和未压缩大小,再写 zlib 压缩后的数据。普通类型是 commit、tree、blob、tag;增量类型是
OFS_DELTA和REF_DELTA。 - 尾部:对前面所有字节计算的 20 字节 SHA-1 校验和。
idx 是另一份文件,负责“对象 ID → pack 内偏移”的查找。idx v2 里有 fanout 表、排序后的对象 ID、CRC32、偏移表,以及对象超过 2 GiB 时才用到的 large offset 表。没有 idx,pack 仍然能被顺序扫描,但每次按对象 ID 取内容都要全表搜索;idx 让随机读取变成近似数组索引。
delta 对象不直接保存完整内容,而是保存“基对象 + 一组复制/插入指令”。复制指令从基对象里搬一段字节,插入指令写入新字节。它本质上是一种二进制 diff,不要求两边是文本,也不要求逐行对齐。
两种 delta 的区别在“怎么找到基对象”:
OFS_DELTA保存一个负偏移,基对象在当前 pack 内的更早位置。它比存 20 字节对象 ID 更省空间,但要求基对象在同一个包里。REF_DELTA保存基对象的 20 字节 ID。它更灵活,基对象可以在包外;thin pack 就依赖这种形式。
git pack-objects 的 --delta-base-offset 会让输出优先使用 OFS_DELTA。官方文档说它通常能再省 3%–5%,git gc/git repack 默认就会用。这个合成仓库 gc 后的 49 个 delta 全部是 OFS_DELTA,没有 REF_DELTA,符合“自包含 pack”的预期。
delta 是怎么选出来的
打包器不会拿所有对象两两比较,那样代价太高。它先按类型、大小、名称等特征排序,再用一个滑动窗口在候选对象之间尝试 delta;窗口大小由 pack.window 控制,默认 10,允许的 delta 链最大深度由 pack.depth 控制,默认 50(上限 4095)。窗口越大、深度越深,越可能找到更长的相似链,但打包时间和读取时的回溯成本也会上升。
这解释了为什么“31 个版本”不等于“1 个完整对象 + 30 个 delta”。实际结果是 2 个完整基对象 + 29 个 delta:打包器可以在窗口里选多个合适的基对象,delta 链也可能分叉,不必强迫每个版本指向前一版。这个仓库里文本 delta 的指令数据大约 100–163 字节,压进 pack 后是 77–108 字节;31 个版本、每个约 310 KB 的文本,历史增量被压到了很小的量级。
二进制文件更能打破“二进制不能 delta”的误解。第一个版本是 98,304 字节随机数据,zlib 后 98,343 字节,几乎压不动——随机内容本来就没有冗余。第二个版本只改了 64 字节,delta 指令数据 83 字节,压进 pack 后 99 字节。可见 delta 利用的是“大部分字节没变”,而不是“内容必须是文本”。随机数据难的是压缩,不是增量。
commit 和 tree 的表现又不一样。96 个对象里,49 个 delta 由 30 个 blob、18 个 tree 和 1 个 commit 组成。tree 每次只改一个 20 字节的对象 ID,很容易 delta;commit 里有作者、时间、提交说明和父提交 ID,差异较大,所以 31 个 commit 中只有 1 个被 delta。这个分布很直观:越模板化、越少变化的对象,越适合增量。
深度是空间与读取的折中
我把同一批对象用不同的深度上限重新打包:默认 pack.depth=50 时 pack 是 151,283 字节,限制成 pack.depth=1 时是 158,844 字节,相差约 5%。默认值用更深的链换来了更小的包。代价是读取某个 delta 对象时,要沿着基对象链一路回溯;链越深,CPU 和缓存压力越大。Git 用深度上限控制这个折中,而不是无限追求最小体积。
还有一条常被忽略的边界:core.bigFileThreshold 默认是 512 MiB。大于这个阈值的文件会被直接压缩存储,不再尝试 delta。也就是说,“Git 会对所有文件做增量”并不成立;大文件走的是另一条路径。把大二进制放进 Git 之前,最好先确认它是否真的需要版本控制,而不是默认“Git 会帮我压得很小”。
四、clone 与 fetch:线上传的又是另一种东西
对象库和 pack 讲清楚之后,传输层就更容易理解。clone/fetch 不是把服务器上的 .pack 文件原样下载,而是双方先协商“你要哪些提交、我已经有哪些提交”,服务端再为差集现场生成一个 pack。
在 protocol v2 里,客户端发送 want(想要的引用或提交)和 have(本地已有的提交),服务端返回 acknowledgments,确认哪些 have 可用,然后发送 packfile 段。服务端知道客户端已经有哪些对象,就可以在 pack 里省略这些公共基对象,只发新增对象以及指向公共基对象的 delta。这种省略了基对象的 pack 就是 thin pack。
thin pack 的“thin”是相对自包含性而言的:它违反了普通 pack 可以独立读取的约定,必须由拥有基对象的客户端补全。git index-pack --fix-thin 会把被省略的基对象追加进 pack,然后重新生成索引。服务端省了带宽,客户端多了一步补全;这是典型的传输优化,不是磁盘格式的常态。
我单独做了一个薄包实验,把机制放大:一个提交只改 310 KB 文本里的一行,用 git pack-objects --thin 生成 3 个对象的包,线上只有 343 字节。
- commit:252 字节数据,压缩后 167 字节;
- tree:
REF_DELTA,25 字节 delta 数据,压缩后 34 字节,基对象是一棵 111 字节的 tree; - blob:
REF_DELTA,58 字节 delta 数据,压缩后 64 字节,基对象是 310,661 字节的旧文本。
客户端执行 index-pack --fix-thin 后,包里补进了两个基对象,变成 5 个对象、25,796 字节。作为对照,那个实验仓库的完整克隆包是 151,631 字节、99 个对象。三个数字分别代表线上传输、补全后的落盘包、完整历史,不能混着比较。
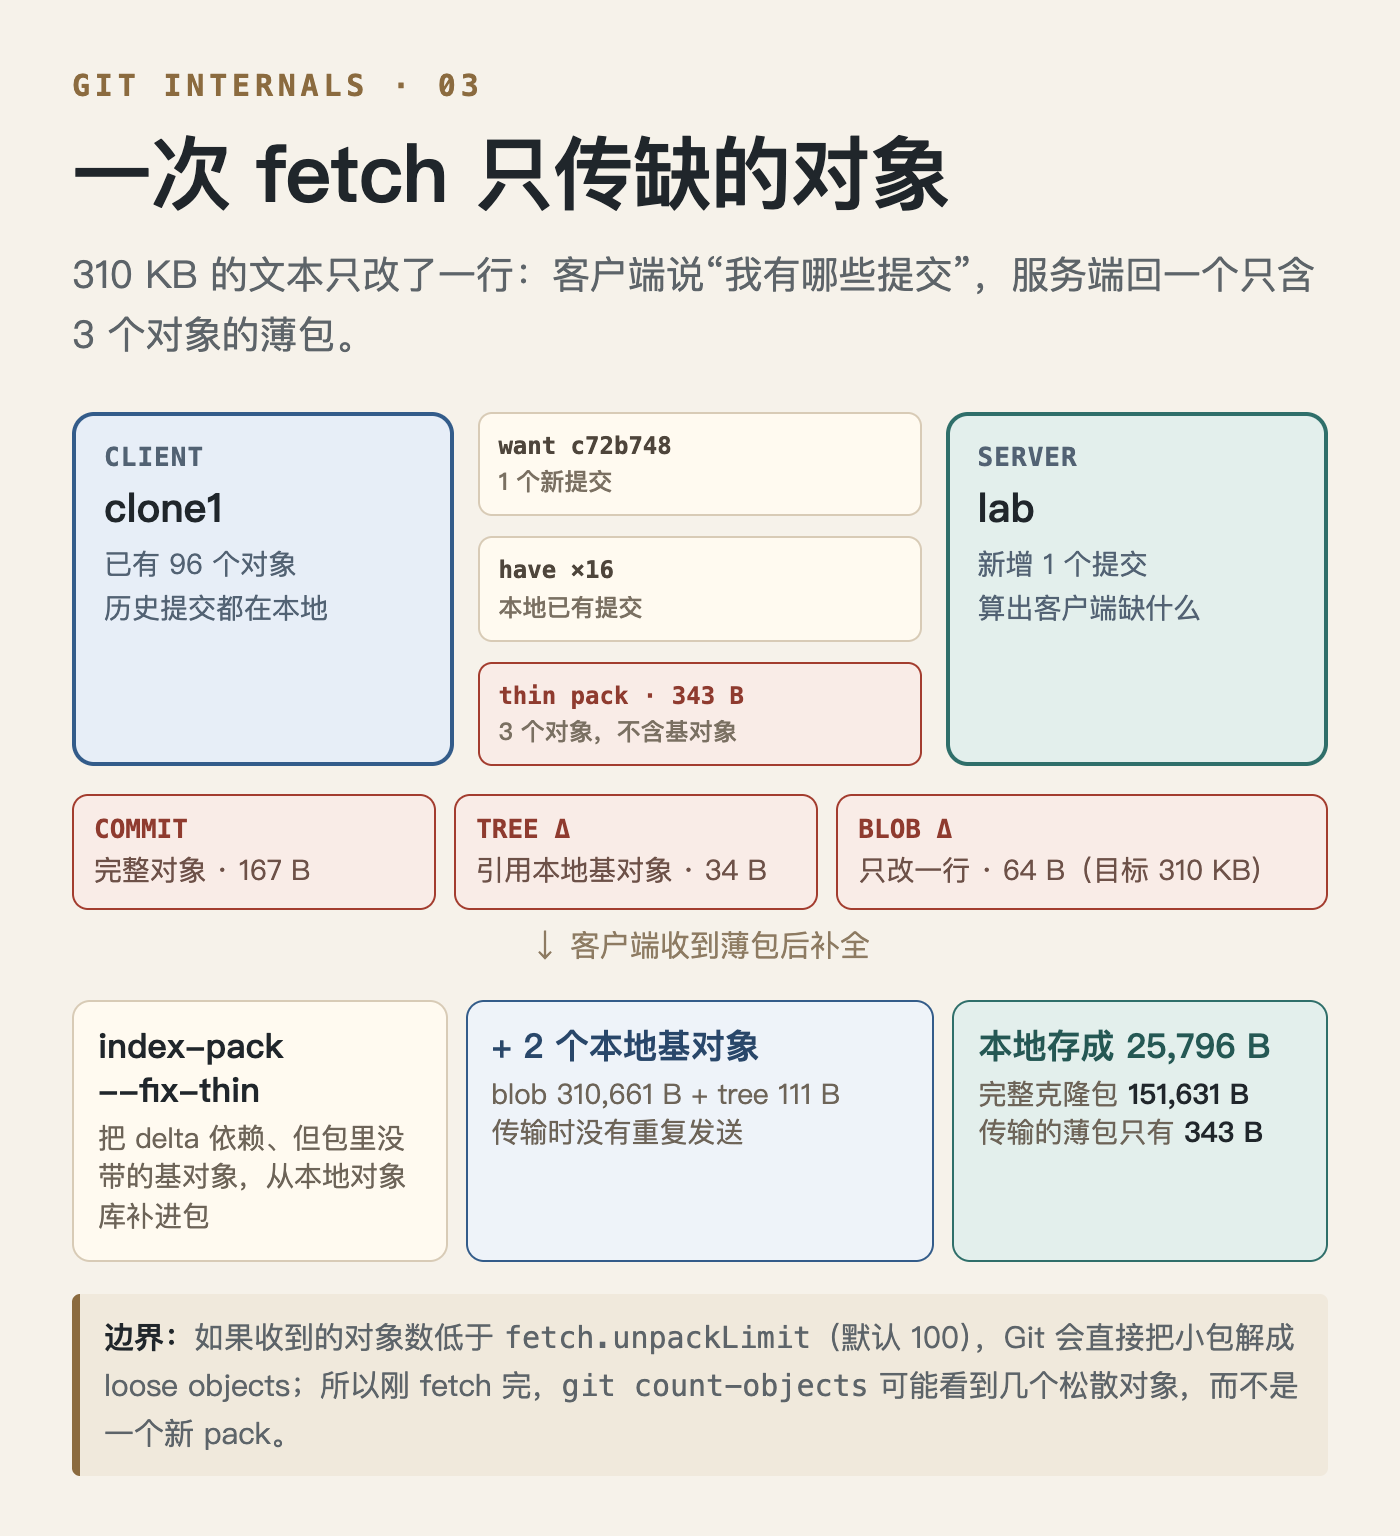
图 3:fetch 先协商 want/have,服务端可发送省略公共基对象的 thin pack;客户端用本地对象补全后再落盘。
真实 fetch 还有一个小细节:收到 pack 不等于磁盘上一定多一个 pack。合成仓库的克隆端做一次 fetch,客户端 want 1 个、have 16 个,服务端 ACK 1 个、ready 1 个,实际收到 3 个新对象(1 commit、1 tree、1 blob)。因为对象数低于 fetch.unpackLimit 的默认值 100,Git 把这 3 个对象解成了 loose object:总对象数从 96 变成 99,而 pack 里的对象数仍然是 96。下次 gc 才会把它们收进 pack。
这也能解释一个常见疑问:为什么刚 fetch 完,git count-objects -v 里会冒出一些 loose 对象?不是仓库坏了,而是小包走了“解包成 loose”的路径。fetch.unpackLimit 可以调整这个阈值,但把它设得过大或过小都有取舍:大包解成很多小文件未必划算,小包强行保留成 pack 也会增加 pack 数量。
五、gc 不是“压缩一下”这么简单
git gc 做的是仓库维护(housekeeping),不只是把 loose 对象打进 pack。它还会合并小 pack、清理过期 reflog、按规则修剪不可达对象,某些版本还会生成 commit-graph、cruft pack 等辅助结构。理解它的默认值,比记住某次 gc 的字节数更有用。
几个常见默认值:
gc.auto=6700:loose 对象大约超过这个数量时,日常命令可能触发自动 gc;gc.autoPackLimit=50:pack 数量超过这个阈值时,倾向于合并;gc.pruneExpire=2.weeks.ago:不可达对象默认保留两周;gc.reflogExpire=90 days、gc.reflogExpireUnreachable=30 days:reflog 的保留窗口。
这些是默认值,不是永恒常数;不同的 Git 版本、不同的仓库配置都可能改变它们。更重要的是,git gc 不是越勤快越好。官方文档明确提醒:git gc --prune=now 与并发写同时运行有损坏仓库的风险。活跃仓库不要把它当成日常清理命令,尤其是在 CI、编辑器或其他进程可能同时写入的时候。
--aggressive 也不是“更高级的 gc”。它会让打包器用更大的窗口和更深的链重新寻找 delta(gc.aggressiveWindow=250、gc.aggressiveDepth=50),花更多 CPU 换更小的包,适合一次性整理,不适合频繁执行。日常维护用默认 gc 就够了;如果要排查对象分布,先用只读命令看清楚,再决定是否重打。
常用的两条诊断命令:
git count-objects -v
git verify-pack -v .git/objects/pack/pack-<hash>.idx
前者看 loose 与 pack 的数量、体积和可修剪对象;后者逐个列出对象类型、未压缩大小、pack 内大小、偏移和 delta 深度。注意 count-objects 的 size/size-pack 默认以 KiB 为单位,verify-pack 的字节数才是逐对象的精确值。比较不同阶段的体积时,先把单位统一。
shallow clone 省掉的是什么
git clone --depth 1 常被当成“只下载最新版本,所以一定很小”。它确实只保留指定深度的历史,但最新快照里的 blob 一个都不能少。合成仓库做 depth=1 的浅克隆,结果是 5 个对象、size-pack: 119 KiB:1 个 commit、1 棵 tree、3 个 blob。历史被截断了,96 KiB 的二进制仍然在最新快照里,所以体积没有想象中那么小。
这也是 shallow clone 的边界:它能减少历史提交和旧 blob,但不能替代对大文件的处理;需要完整历史的 merge-base、blame、log 也会受影响。另一个方向是 partial clone,例如 --filter=blob:none 延迟下载 blob,按需再取。它和 shallow 解决的不是同一个问题:一个裁剪历史深度,一个延迟对象内容。把两者混为一谈,容易在需要历史或离线访问时踩坑。
六、把数字放在一张表里
| 阶段 | 关键结果 | 说明 |
|---|---|---|
| loose | 96 个 / 1,300 KiB | 一个对象一个 zlib 文件 |
| 一次 gc | 151,310 B + 3,760 B idx | 47 个完整对象、49 个 delta |
| 文本历史 | 2 基 + 29 delta | delta 压缩后 77–108 B |
| 二进制第二版 | 99 B delta | 改 64 B,96 KiB 随机数据 |
| fetch 新增 | 3 个 loose | 低于阈值 100 |
| thin pack | 343 B → 25,796 B | 补入 2 个基对象 |
| shallow depth 1 | 5 个 / 119 KiB | 仍含 96 KiB 二进制 |
这些数字能说明机制,但不能直接外推成容量规划:
- 仓库是合成的,文本内容高度重复,8.6 倍不是通用压缩率;真实仓库的 delta 命中率、对象大小分布和文件类型都不一样。
count-objects的体积是 KiB 级四舍五入值,pack 字节数是文件精确大小;两者只能做量级比较。- 打包结果受窗口、深度、对象顺序和 Git 版本影响。同一批对象重新打包,字节数都可能有小幅变化。
- 这是一次本机单次实验,没有把冷缓存、并发、磁盘 I/O 和超大仓库纳入。它适合解释结构,不适合当性能基准。
七、实践上怎么用这些结论
第一,不要因为“怕仓库变大”而不敢提交。 Git 的逻辑层是快照,但未变对象会复用;真正需要担心的是大量不可压缩、频繁变更、又必须保留历史的大文件,而不是普通的源码提交。
第二,不要把“二进制不能 delta”当成规则。 delta 看的是字节相似度,不是文件扩展名。随机二进制难以压缩,但只改少量字节时仍然可以有很小的 delta;反过来,文本如果每次大段重写,也未必能压得很小。判断一个仓库为什么大,应该看对象分布和 delta 深度,而不是猜文件类型。
第三,排查体积先只读。 git count-objects -v 看 loose/pack 比例,git verify-pack -v 看大对象和 delta 链,git rev-list --objects --all 找大路径。确认原因后再决定 git gc、git repack 或把大文件迁到 LFS;不要一上来就 --aggressive 或 --prune=now。
第四,理解 fetch 的落盘策略。 小 fetch 变成 loose 是正常行为;pack 数量、loose 数量和 unpackLimit 的关系,比“fetch 一定生成 pack”更接近实际。看到 count-objects 变化时,先分清它是新增对象、解包,还是 gc 合并。
第五,大文件用对工具。 Git LFS 把大文件内容放到外部存储,仓库里保留指针;它不是唯一方案,但对“需要版本控制、又不需要每次 clone 都拉完整历史”的场景很常见。另一条路是 partial clone/按需取对象。选哪种,取决于团队是否需要离线、是否需要历史、以及托管平台的支持情况。
回到开头:git show 里的 diff 是真的,但它属于读取层的视图;提交对象里的 tree 也是真的,它属于存储层的快照;packfile 里的 delta 同样是真的,它属于物理层的压缩。把这三层分开,就不会再问“Git 到底存 diff 还是存快照”这种二选一的问题——它逻辑上存快照,物理上对相似对象做增量,传输时再根据双方已有的对象临时决定发什么。
理解这一点,git gc 的耗时、clone 的体积、fetch 后的 loose 对象、以及大二进制为什么让人头疼,就不再是彼此孤立的现象,而是同一套对象模型在不同层面的表现。
资料来源
- Pro Git: Git Internals – Git Objects
- Pro Git: Git Internals – Packfiles
- gitformat-pack
- git-pack-objects
- git-index-pack
- gitprotocol-v2
- git-gc
- git-config
- git-count-objects
- git-clone
- git-verify-pack
本地实验为 2026-11-22 在单机完成的一次运行,环境是 Git 2.54.0(Apple Git-157);复现时数值可能因版本、打包参数和缓存状态略有不同。