SQLite 经常被描述成“一个文件、一个连接”的嵌入式数据库。文件确实通常只有一个,但连接可以很多;打开 WAL 模式之后,一个连接在写的同时,另一个连接可以读,而且读到的是一份一致的快照。
这不是把锁去掉了,而是把“改主文件”换成了“追加日志”。理解这一点,才能理解 WAL 的三个代价:checkpoint、磁盘占用和备份方式。
先把结论放在前面:
- WAL 让读不阻塞写、写不阻塞读,靠的是“提交只追加日志,读者按自己的水位读快照”;
- 写者仍然只有一个,所谓并发是“读写并发”,不是“多写并发”;
- 代价转移到了别处:长读事务会让 WAL 变大,checkpoint 可能被读者卡住,只拷主文件的备份会静默缺数据。
下面按“提交路径—快照—checkpoint—文件结构—耐久性—备份—边界”的顺序拆开讲。文中的数字来自一台普通笔记本上的合成数据实验,不是生产基准。
一、两条提交路径
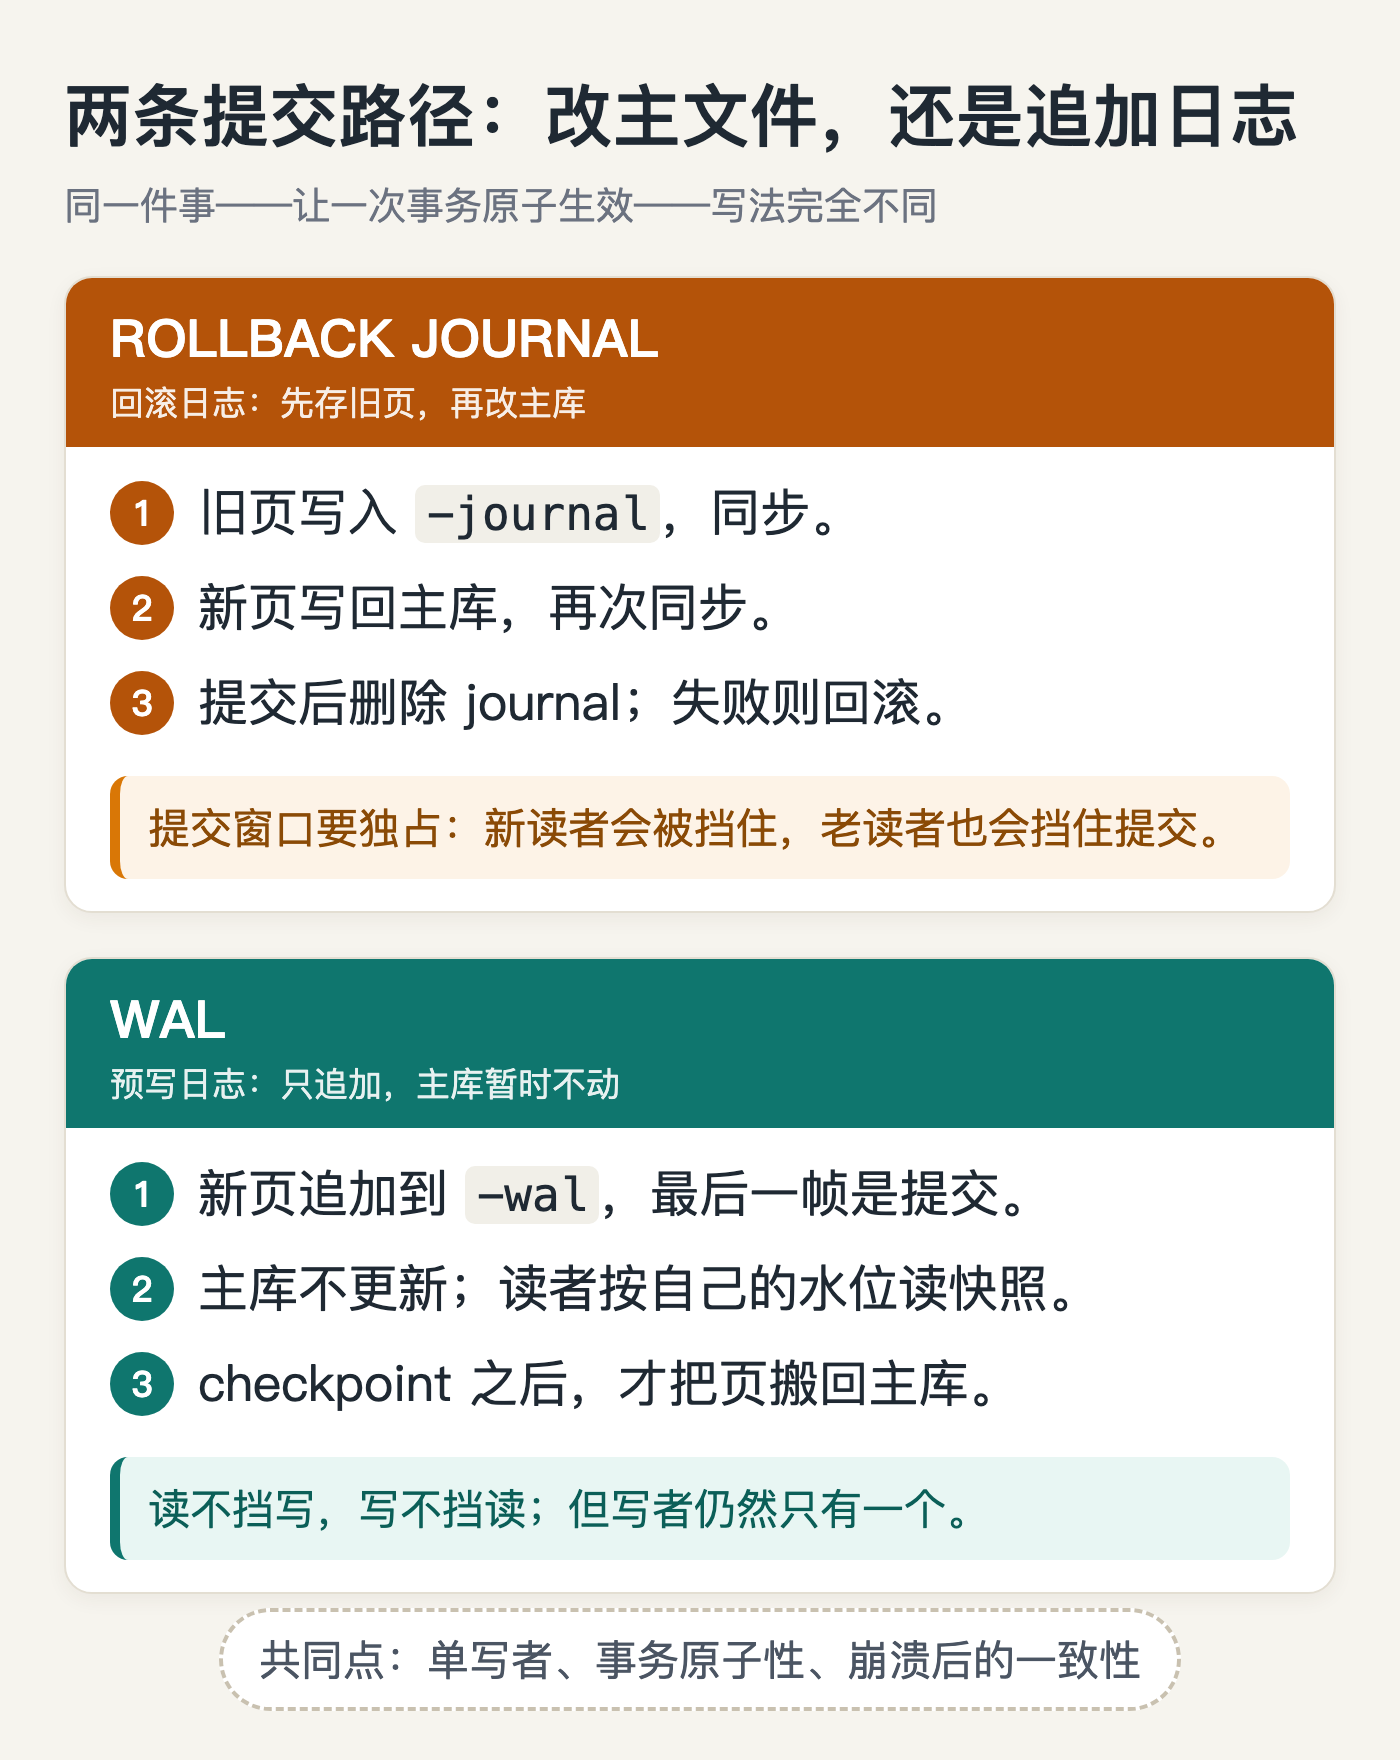
传统 SQLite 用回滚日志(rollback journal)。事务修改页面之前,先把旧页写进 -journal 文件并同步;提交时把新页写回主数据库并再次同步,最后删除 journal。崩溃恢复时,用 journal 里的旧页把主库改回去。
WAL 反过来:旧内容留在主库不动,新页追加到 -wal 文件;提交完成的标志,是日志里出现一个特殊的提交帧。主库可以在一段时间内保持旧状态,读者从 WAL 里取新页,从主库里取旧页。
| 维度 | 回滚日志 | WAL |
|---|---|---|
| 提交写到哪里 | 主数据库文件 | -wal 顺序追加 |
| 读者与提交 | 提交阶段要独占,挡住新读者 | 提交不挡读者,读者不挡写者 |
| 写者数量 | 一个 | 一个 |
| 额外文件 | -journal,提交后删除 |
-wal、-shm,通常常驻 |
| 备份 | 没有活动事务时拷主文件 | 必须带 -wal,或用备份 API |
这里最容易误解的是第二行。回滚日志模式下,写事务执行过程中读者仍然可以读;真正互斥的是提交窗口——写者要拿排他锁,把新页落盘、删除 journal。WAL 把这一步也改成了追加,所以读者在整个提交过程中都不需要让路。
代价是:主库不会立刻更新。要把 WAL 里的内容搬回主库,需要另一个动作——checkpoint。
二、快照:读者为什么看不到刚提交的数据
WAL 模式下,一个读事务开始时,会记住 WAL 里最后一个有效提交帧的位置,官方把这个位置叫 end mark。之后无论 WAL 追加了多少新事务,这个读者都只看到 end mark 之前的内容。
读一页时,SQLite 先查 WAL:这一页在 end mark 之前最后出现在哪一帧?有就用 WAL 里的版本,没有才读主库。为了不每次都从头扫 WAL,SQLite 维护了一个叫 wal-index 的索引,回答“给定页号 P 和上限 M,P 最后一次出现在哪一帧”。它放在 -shm 文件里,通过内存映射当共享内存用;崩溃后可以从 WAL 重建,所以是瞬态结构。
这也解释了 WAL 的一个硬限制:所有进程必须在同一台机器上。不同机器没法共享这块内存,因此 WAL 不支持跨机器的网络文件系统。
我用两个连接做了一次最小实验:读连接先开事务并读一次(建立快照),写连接随后插入两行并提交。代码块在窄屏上可以横向滑动查看完整行。
r = sqlite3.connect("demo.db", isolation_level=None)
r.execute("PRAGMA journal_mode=WAL")
r.execute("BEGIN")
before = r.execute("SELECT count(*) FROM items").fetchone()[0]

w = sqlite3.connect("demo.db")
w.execute("INSERT INTO items(v) VALUES (1), (2)")
w.commit()

during = r.execute("SELECT count(*) FROM items").fetchone()[0]
fresh  = sqlite3.connect("demo.db").execute(
         "SELECT count(*) FROM items").fetchone()[0]
r.execute("COMMIT")
after  = r.execute("SELECT count(*) FROM items").fetchone()[0]
| 观察点 | 行数 |
|---|---|
| 读事务开始,写入前 | 100 |
| 写连接已提交,同一读事务 | 100 |
| 提交后新开的连接 | 102 |
| 读事务结束后再读 | 102 |
同一时刻,数据库里存在两个版本:老读者看 100 行,新读者看 102 行。这不是缓存不一致,而是 WAL 有意提供的多版本快照。
有个细节值得记住:快照是在第一次读取时建立的,不是执行 BEGIN 的那一刻。如果先 BEGIN、很久以后才读第一行,中间提交的事务会包含在快照里。反过来,读事务一旦读到数据,就会一直钉在那一刻,直到提交或回滚。
“钉住”是有代价的。老读者还在读的页,checkpoint 不能覆盖;读者活得越久,WAL 越难被回收。
三、checkpoint:把账还回主文件
checkpoint 做的事很直白:把 WAL 里的页按页号顺序搬回主数据库,然后同步主库。它不改变事务的可见性,也不是提交的一部分;它只是把“账”从日志还回主文件。
问题在于,checkpoint 不能无脑往前推。假设一个读者还停在 end mark 100,checkpoint 却把第 120 帧的页写回主库,而这一页的旧版本正是读者还要读的——读者的快照就被破坏了。所以规则是:checkpoint 最多推进到所有活动读者 end mark 的最小值。
我把自动 checkpoint 关掉,用一个读事务先钉住空表,然后让另一个连接做 200 次自动提交,每次写入 1 KiB 的合成数据。WAL 长到 333 帧、1,371,992 字节时,执行 PRAGMA wal_checkpoint(PASSIVE):
| 时点 | 返回值 (busy, log, checkpointed) |
WAL 字节 |
|---|---|---|
| 读事务仍钉住 | (0, 333, 0) |
1,371,992 |
| 读事务结束后再 PASSIVE | (0, 333, 333) |
1,371,992 |
| 再执行 TRUNCATE | (0, 0, 0) |
0 |
三个数字分别是:是否被阻塞、日志里有多少帧、成功搬回主库多少帧。第一列是 0,不代表“有进展”——PASSIVE 从不等待,也从不因为被读者挡住而报 busy;它只是搬不动,于是第三列停在 0。读完这张表,再看“checkpoint 成功返回”这句话,含义就完全不同了。
读事务关闭后,PASSIVE 一次搬完了 333 帧,但 WAL 文件大小没有变。默认策略是复用文件,而不是每次截断;要主动把它缩到 0,需要 TRUNCATE,或者设置 journal_size_limit。这也解释了为什么很多线上库的 -wal 会稳定停在某个大小,而不是提交完就消失。
自动 checkpoint 默认在 WAL 达到 1000 页时触发,由执行提交的那个线程顺手做。4 KiB 页下大约是 4 MB。它同样是 PASSIVE:能搬多少搬多少,不等待读者。如果一直有长读事务,checkpoint 可能长期无法完成,WAL 就会持续增长,读性能也会随着 WAL 变大而下降。
四种 checkpoint 模式的差别,可以记成一句话:PASSIVE 不等人,FULL 等到没有写者且读者都在最新快照,RESTART 再等到所有读者结束以便下次从头写,TRUNCATE 最后把文件截成 0。FULL、RESTART、TRUNCATE 在等不到时会调用 busy handler,可能返回 busy;PASSIVE 不会。
四、拆开 WAL 文件
WAL 文件的结构不复杂:一个 32 字节的文件头,后面是一串帧;每帧由 24 字节的帧头和一整页数据组成。
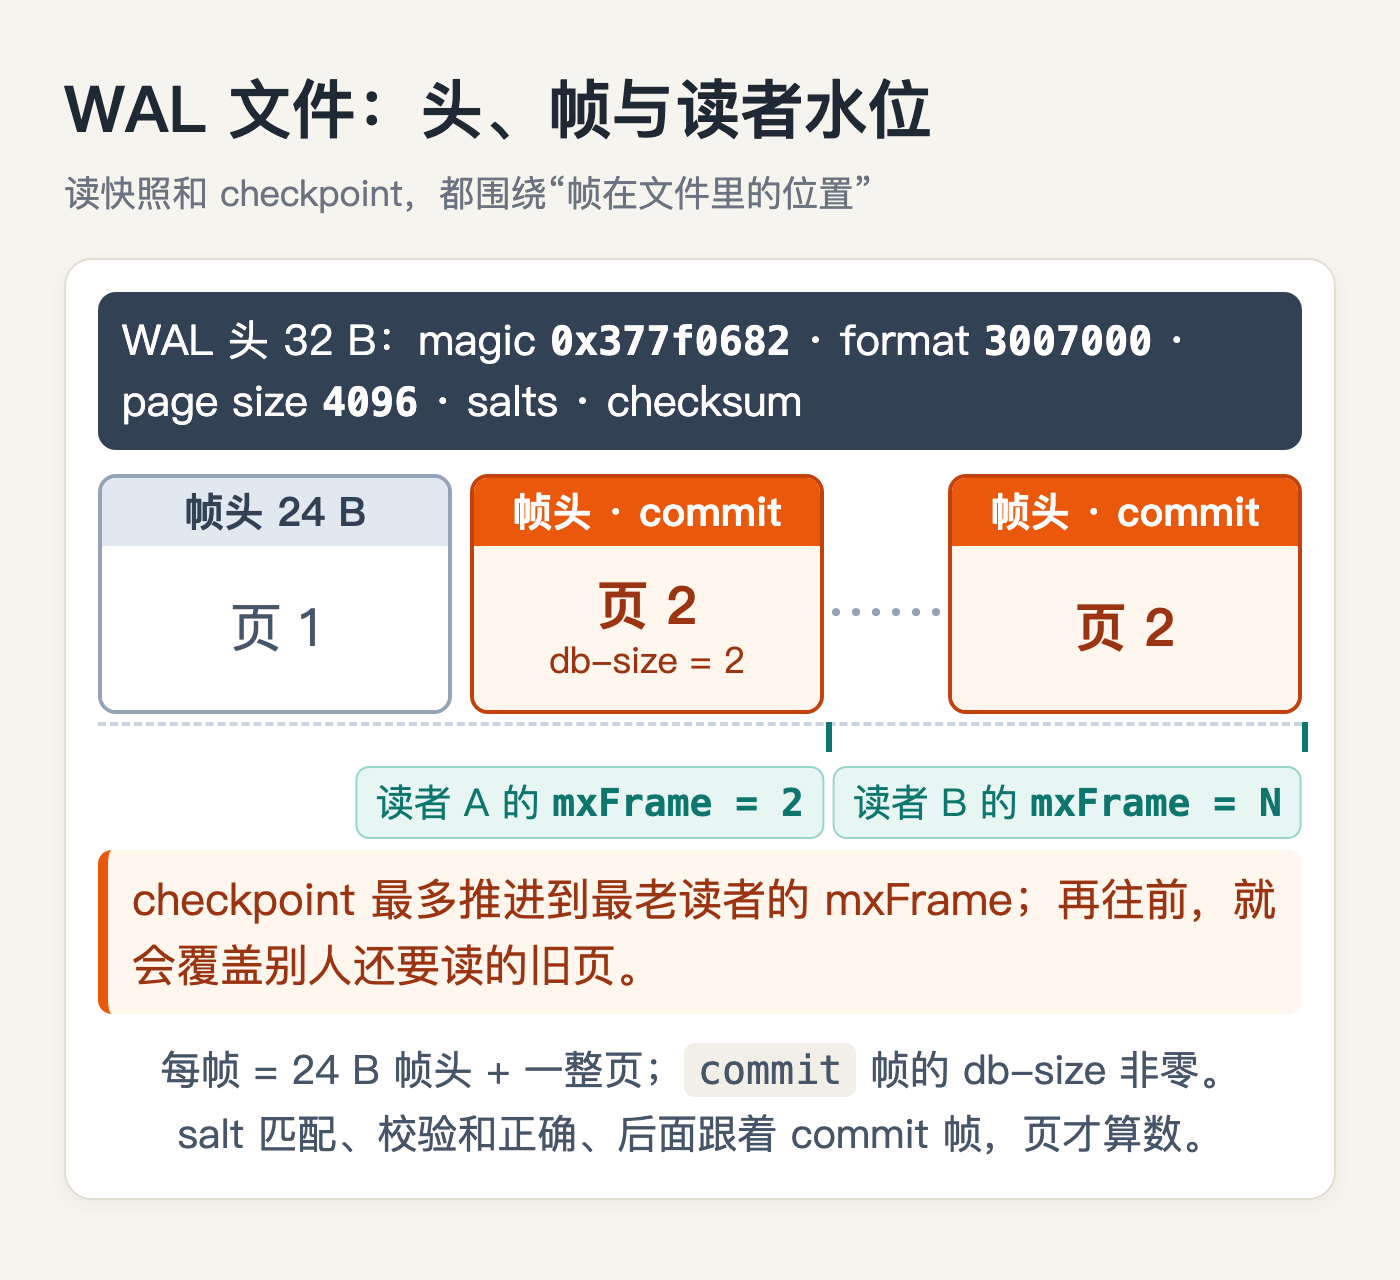
文件头里比较关键的字段是:magic(0x377f0682 或 0x377f0683,区别是校验和按大端还是小端算)、格式版本、页大小、checkpoint 序号、两个 salt,以及头部校验和。帧头里则是页号、提交后的数据库大小、两个 salt 和两个校验和。
一帧是否是提交帧,看“提交后的数据库大小”是否非零。一个事务的所有帧是连续存放的,最后一帧是提交帧;如果文件尾部只写了一半、没有提交帧,这些帧在恢复时会被忽略。salt 用来识别 WAL 是否被重置:重置时 salt 改变,旧帧自动失效,不会被误认为新内容。
我用 struct 解析了一次实验产生的 WAL:
- 文件 49,472 字节,正好等于
32 + 12 × (24 + 4096); - magic 是
0x377f0682,格式版本3007000,页大小 4096; - 12 帧里有 11 个提交帧(第 2 到第 12 帧);
- 所有帧的 salt 都与头部一致,涉及的页号只有 1 和 2;
- 最后一个提交帧记录的数据库大小是 2 页。
这组数字说明了一件容易被忽略的事:WAL 记录的是页,不是行。一次只改一行的提交,也可能写入一整页 4 KiB。前面 200 次 1 KiB 写入产生约 1.31 MiB 的 WAL,写放大接近 7 倍,原因就在这里。
五、耐久性:一致不等于不丢
WAL 模式下,synchronous 决定提交时是否真的把日志刷到持久存储。
| 设置 | 提交时 | 断电/系统崩溃后 | 应用进程崩溃后 |
|---|---|---|---|
| FULL | 同步 WAL | 已提交事务保留,ACID | 保留 |
| NORMAL | 不同步,checkpoint 时才同步 | 数据库一致,但最近已提交事务可能回滚 | 保留 |
| OFF | 不同步 | 可能损坏 | 保留 |
官方文档的措辞很明确:WAL + NORMAL 永远是一致的,不会因为断电而损坏,但会丢失耐久性——断电后,最近提交的事务可能被回滚。应用崩溃则不受影响,无论哪种设置,已提交事务都在。
我的实验环境里,切到 WAL 后 PRAGMA synchronous 返回 1(NORMAL)。官方文档把 FULL 描述为默认值,但默认值可以通过编译选项修改,不同发行版、不同语言绑定未必一致。这不是“文档错了”,而是提醒:不要凭记忆假设安全级别,连上数据库先查一次。
PRAGMA journal_mode;
PRAGMA synchronous;
PRAGMA wal_autocheckpoint;
PRAGMA wal_checkpoint(PASSIVE);
前三条告诉你当前模式、同步级别和自动 checkpoint 阈值;最后一条返回 (busy, log, checkpointed),能看出日志有没有积压。
六、备份:最容易静默出错的地方
很多人备份 SQLite 的方式是 cp app.db backup.db。在回滚日志模式下,只要没有活动事务,这通常没问题;在 WAL 模式下,它可能成功、能打开、integrity_check 也返回 ok,但数据少了。
我做了这样一个实验:先写入 50 行,checkpoint 并截断 WAL,让主库包含这 50 行;再自动提交 5 行,让它们只存在于 WAL 里;然后只复制主库文件。
| 备份方式 | 读到的行数 | integrity_check |
|---|---|---|
| 只复制主库文件 | 50 | ok |
VACUUM INTO 在线复制 |
55 | ok |
| 在线库本身 | 55 |
主库是 8,192 字节,WAL 是 20,632 字节(5 帧)。只拷主库得到的文件完全健康,只是停在了上一次 checkpoint 的时刻。这种错误不会报错,也不会被完整性检查发现,只有在恢复时才会发现少了几行。
官方对这件事的定义是:WAL 文件是数据库持久状态的一部分,数据库被复制或移动时必须和 WAL 一起带走;如果主库和 WAL 被分开,已经提交的事务可能丢失,数据库甚至可能损坏。-shm 则是瞬态索引,不需要备份。
安全的做法有三种:
- 用 SQLite 的在线备份 API,它会对源库做一致性快照;
- 用
VACUUM INTO 'backup.db',在运行中生成一个不带 WAL 的完整副本; - 用
sqlite3_rsync在运行中复制到本机或远端。
如果一定要做文件级复制,至少要先停掉所有连接,让最后一个连接关闭时完成收尾 checkpoint 并删除 WAL,再复制主文件。不要在还有连接写入时,只抓一个主库文件。
七、边界与常见误区
- WAL 不是“没有锁”。它仍然只有一个写者;两个写事务不能同时提交。读写可以并行,多写不行。
- 不能放在跨机器的网络文件系统上。wal-index 依赖同机共享内存;NFS、SMB 上多客户端访问 WAL 数据库不在支持范围内。
- 长读事务会拖住 checkpoint。报表查询、调试时忘了提交的会话、连接池里长期挂起的事务,都会让 WAL 只增不减。监控
-wal大小,比监控“有没有报错”更早发现问题。 - checkpoint 不等于截断。默认只复用文件;要缩小文件,需要
TRUNCATE或设置journal_size_limit。 - 页大小进入 WAL 后不能改。要改页大小,必须先切回回滚日志模式,再用
VACUUM重建。 - 大事务不适合 WAL。官方建议超过几十 MB 的事务考虑回滚日志;超过 1 GB 的 WAL 事务可能直接因 I/O 或磁盘满失败。3.11 之后大事务的效率已经改善,但 WAL 文件体积仍然会随事务增长。
- WAL 不一定更快。读多写少、并发读多的场景收益明显;几乎只读、极少写的场景,WAL 可能还慢百分之一二,因为多了一层间接。
- 模式是持久的。对一个库执行
PRAGMA journal_mode=WAL后,它会一直保持 WAL,直到显式切回其他模式;新连接不需要重复设置。 - 实现也会有 bug。SQLite 3.7.0 到 3.51.2 存在一个罕见的 WAL-reset 竞态,可能在“两个连接同时写或 checkpoint”时导致损坏;3.51.3 修复,3.44.6 和 3.50.7 有回补。概率很低,但升级成本更低的场景没理由不升。
八、上手前的检查清单
PRAGMA journal_mode是不是wal?切换是否真的成功,而不是被 VFS 拒绝后静默保持原模式?PRAGMA synchronous是多少?业务能不能接受 NORMAL 下断电丢失最近若干事务?PRAGMA wal_autocheckpoint是否还是默认的 1000 页?有没有被应用代码改成 0?- 有没有长读事务?连接池、ORM 会话、报表任务分别持有多久?
-wal的大小是否稳定?如果持续增长,是读者挡住 checkpoint,还是写入量本身太大?- 备份是不是只拷了主文件?恢复演练有没有真的比对过行数或业务校验和?
- 页大小是否已经确定?如果以后要改,是否接受一次
VACUUM重建? - SQLite 版本是否包含 WAL-reset 修复?多连接写入的场景尤其要确认。
九、实验环境与来源
实验在一台 macOS arm64 机器上完成,使用 Python 3.9.6 自带的 sqlite3,SQLite 版本 3.54.0。数据全部是合成数据,只测机制,不测吞吐;文中的字节数、帧数和行数都来自这次实验的输出,不是生产库采样。
主要来源:
- Write-Ahead Logging:机制、并发、checkpoint、WAL 文件、reset bug
- Database File Format:WAL 头与帧格式
- PRAGMA journal_mode、synchronous、wal_checkpoint
- Backup API、VACUUM INTO、sqlite3_rsync
一句话总结:WAL 用“追加日志 + 读者水位”换来了读写并行,但把复杂度推给了 checkpoint、磁盘空间和备份。知道这三笔账记在哪里,才算真正会用 WAL。